Guía técnica · Generación de vídeo con MiniMax-H3
MiniMax H3De un prompt a un vídeo con sonido
Despliega MiniMax-H3 en QDivZero y genera vídeos a partir de texto. Guía paso a paso con ejemplos, código Python y mediciones de tiempo y coste.

Contenido de la guía5 secciones
Una tetera sobre una mesa, vapor saliendo de una taza y una cámara que se acerca despacio. Vamos a pedirle esa escena a MiniMax-H3, descargar el vídeo y cambiar después la escena para generar una segunda versión. Lo haremos primero en QDivZero y después desde Python.
El modelo se ejecuta en una GPU de tu despliegue. Desde tu ordenador envías el prompt y recibes un MP4 con vídeo y audio. No necesitas instalar el modelo ni tener una tarjeta gráfica local.
Antes de reservar la GPU, revisa la licencia de MiniMax-H3. Su licencia pública excluye la Unión Europea, Reino Unido, Corea del Sur y Estados Unidos; el uso en esos territorios requiere una autorización aparte de MiniMax. Desplegarlo en QDivZero no elimina esa condición.
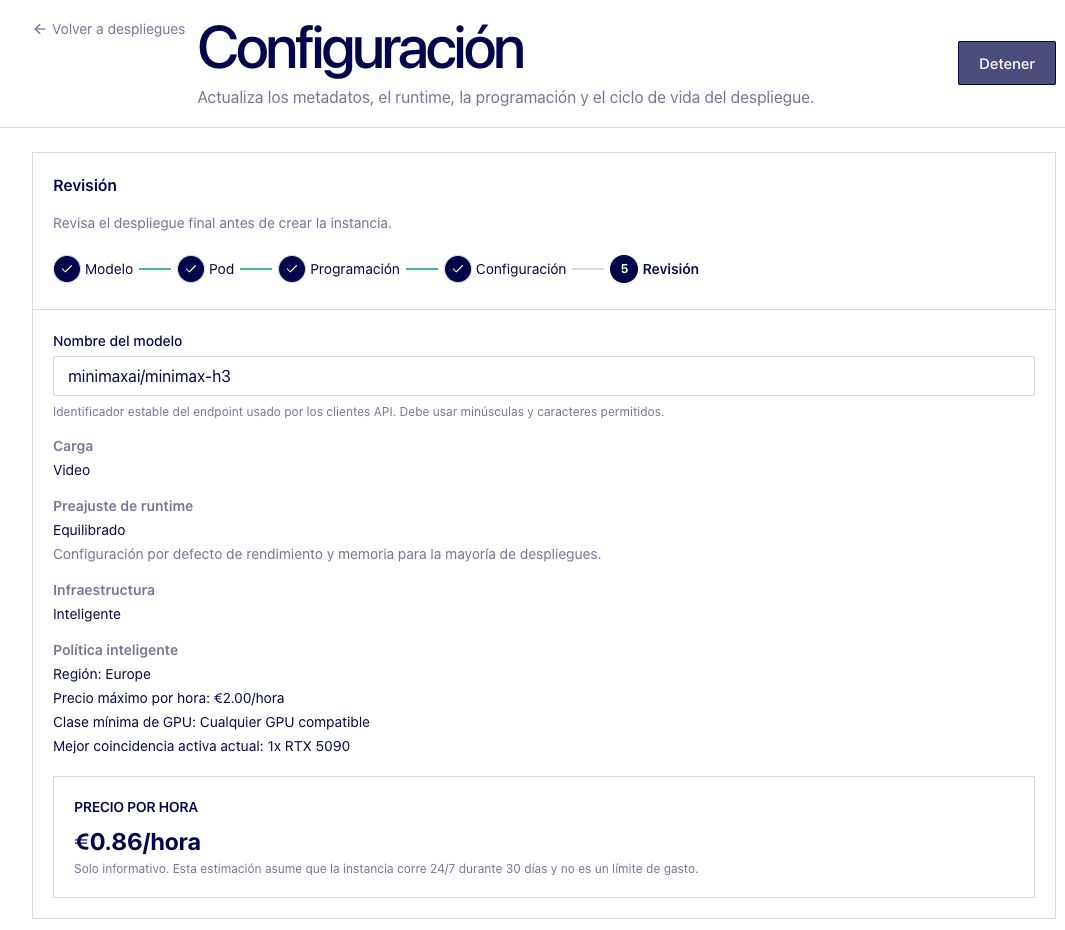
1. Despliega MiniMax-H3
Necesitas una cuenta de QDivZero con saldo. Para los ejemplos de Python, también necesitarás una clave API y el ID de tu cuenta; puedes dejarlos para el paso 3.
- Entra en Despliegues y pulsa Desplegar modelo.
- Elige Elegir manualmente y busca
MiniMaxAI/MiniMax-H3. Selecciona el repositorio oficial, identificado como Video. - Continúa a Pod. El modo Inteligente busca capacidad compatible con el modelo y prepara el runtime que necesita.
- Elige la región permitida para tu despliegue. Si marcas una región concreta, desmarca Sin región para que la selección quede limitada.
- Fija un Precio máximo por hora. Es el límite de la oferta de GPU; el gasto total dependerá del tiempo que permanezca encendida.
- Para esta primera sesión, desactiva Permitir capacidad interrumpible. Generar un vídeo puede tardar varios minutos y una interrupción de Spot puede obligarte a repetir la petición.
- En Programación, añade una regla Detener a la hora en que quieras terminar. Revisa la zona horaria junto al cron.
- En Configuración, escribe un nombre que reconozcas, como
MiniMax H3 · guía de vídeo. Deja Serverless y Conjunto de réplicas desactivados durante la prueba. - En Revisión, usa
minimaxai/minimax-h3como Nombre del modelo. Ese será el identificador del endpoint para el laboratorio y la API. - Pulsa Desplegar modelo. Cuando aparezca en la lista, abre su fila y elige Estado del modelo → Iniciar modelo. Espera a que termine de arrancar.
Crear el despliegue y encender el modelo son dos pasos distintos. Si el estado es No iniciada, todavía falta el segundo. Si está Pendiente, el servidor aún se está preparando.
El precio del asistente es una estimación de la capacidad disponible en ese momento. En modo Inteligente puede cambiar entre la vista previa y el arranque; anota la tarifa de la instancia que finalmente se ponga en marcha.
2. Genera un vídeo desde texto
Abre Desarrolladores, elige Generar video en Tarea y selecciona minimaxai/minimax-h3 en Modelo. En Tarea de generación, deja marcada T2VA. Significa texto a vídeo y audio: para este ejemplo no tienes que adjuntar archivos.
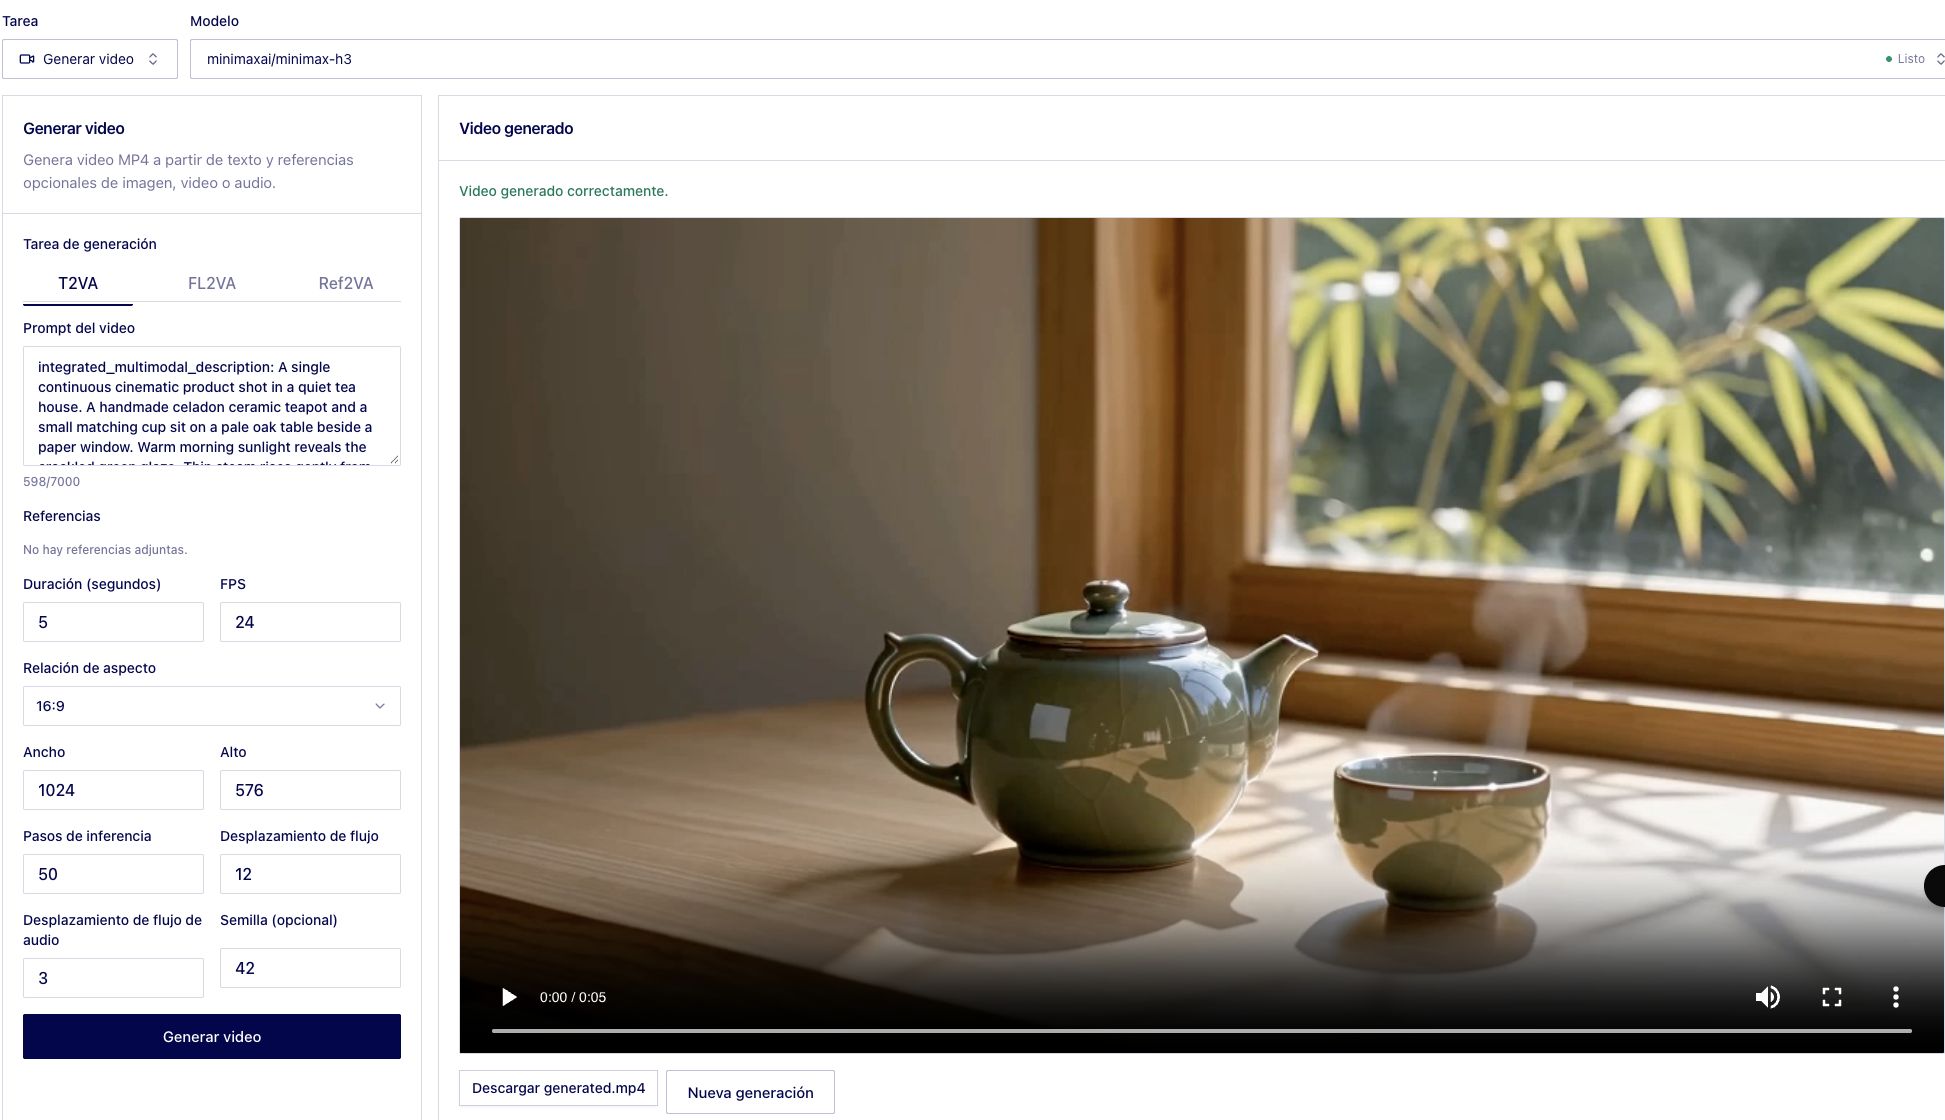
Pega este texto en Prompt del video.
1integrated_multimodal_description: A single continuous cinematic product shot in a quiet tea house. A handmade celadon ceramic teapot and a small matching cup sit on a pale oak table beside a paper window. Warm morning sunlight reveals the crackled green glaze. Thin steam rises gently from the cup throughout the five-second shot. The camera slowly pushes closer, keeping the teapot shape stable and the cup in frame. No cuts, no people, no lettering, no logos.
2overall_soundscape: Quiet indoor ambience and a faint breeze moving the bamboo outside the window. No speech.
3non_diegetic_music: None.
4
El prompt describe lo que se ve, el movimiento de la cámara y lo que se oye. Los tres nombres de campo forman parte del texto que recibe el modelo; no son parámetros adicionales de la API. Seguimos la estructura de la guía de prompting de MiniMax para que la escena y el sonido queden separados.
Usa estos valores en el laboratorio.
Pulsa Generar video una sola vez. El panel muestra el tiempo transcurrido mientras espera la respuesta. Al terminar, reproduce el resultado completo, escucha el audio y guarda el MP4 antes de enviar otro prompt.
Los cinco segundos del formulario son la duración del vídeo resultante. El tiempo de generación es otro dato: depende de la GPU, del tamaño, de los pasos y del estado del servidor.
En nuestra primera petición, una RTX 5090 tardó unos siete minutos en devolver este clip. A 0,79 €/hora, son aproximadamente 0,09 € de cómputo durante la petición. Más abajo veremos cómo sumar el arranque y las pausas para calcular el coste de la sesión.
Cambia una cosa cada vez
Para el segundo ejemplo usaremos una escena con agua, bambú y una barca. La cámara permanece quieta: el movimiento lo aportan la barca, las hojas y el río. El prompt completo está en prompts.json, bajo la clave river.
1integrated_multimodal_description: A single continuous wide shot of a small wooden boat drifting slowly from left to right on a calm river in southern China. Rounded limestone mountains fade into morning mist. Green bamboo leaves in the near foreground sway softly in the breeze, and gentle ripples spread behind the boat. The camera remains still for the entire five-second shot. Natural cinematic light, restrained jade green and warm ivory colors, no cuts, no people visible, no text, no logos.
2overall_soundscape: Gentle water lapping, rustling bamboo leaves and distant birds. No speech.
3non_diegetic_music: None.
4El modelo ha añadido una persona en la barca aunque pedimos que no apareciera nadie. Si ese detalle importa para tu pieza, tendrás que ajustar el prompt o generar otra versión. Una petición correcta no garantiza que el vídeo cumpla todas las instrucciones.
Cuando ajustes tus propios vídeos, empieza por una escena y una acción. Una cámara que se acerca lentamente es más fácil de evaluar que una secuencia con varios cortes y personajes. Mantén la semilla y los parámetros mientras cambias el prompt, y guarda cada versión para compararlas.
La semilla ayuda a repetir un experimento dentro del mismo entorno. No garantiza un archivo idéntico si cambian la GPU, el runtime o el modelo.
3. Guarda el MP4 desde Python
Descarga generate_video.py y prompts.json en la misma carpeta. El script usa Python 3.11 o posterior y no requiere paquetes adicionales.
Configura tu clave API y el ID de tu cuenta. Este último aparece como X-Account-Id en Desarrolladores → Ver código.
1export QDIV0_API_KEY='TU_CLAVE_API'
2export QDIV0_ACCOUNT_ID='ID_DE_TU_CUENTA'
3
4python3 generate_video.py \
5  --model minimaxai/minimax-h3 \
6  --example tea \
7  --output resultados/te.mp4
8
El comando guarda te.mp4 y te.json. El JSON contiene el prompt, los parámetros y la duración de la petición, sin las credenciales. Para la escena del río, cambia a --example river y utiliza otro nombre de salida.
Si el vídeo o su archivo de metadatos ya existen, el script se detiene antes de enviar otra petición. Usa un nombre distinto para cada resultado.
Qué se envía a QDivZero
El endpoint es POST https://api.qdiv0.com/v1/videos. La petición utiliza multipart/form-data también cuando solo envías texto. Los campos principales del primer ejemplo son estos.
1model=minimaxai/minimax-h3
2task=t2va
3prompt=El texto completo de la escena
4duration=5
5width=1024
6height=576
7aspect_ratio=16:9
8num_inference_steps=50
9flow_shift=12
10audio_flow_shift=3
11seed=42
12
La clave se envía en Authorization: Bearer … y la cuenta en X-Account-Id. La respuesta correcta contiene los bytes del MP4, que se escriben directamente en disco; no hay que consultar después un ID de trabajo.
La conexión permanece abierta mientras el modelo genera el vídeo. Si tu aplicación tiene un límite de espera corto, una petición puede terminar con un error aunque la GPU siga trabajando. El ejemplo no repite las peticiones automáticamente: antes de volver a intentarlo, mira el estado del despliegue.
4. Mide el tiempo y apaga la GPU
Estas son nuestras pruebas del 19 de octubre de 2026 con una RTX 5090 a 0,79 €/hora, sin Spot. Las dos pidieron cinco segundos a 1024 × 576, 24 fps, 50 pasos y semilla 42.
Las pruebas se hicieron con una sola petición en curso. Pedimos cinco segundos y recibimos MP4 de unos 5,17 segundos, con el audio original. Puedes descargar los parámetros e intervalos de medición. El tiempo incluye la espera del servidor y la transferencia hasta el laboratorio.
Al usar el script de Python, su JSON guarda request_seconds, desde el envío de la petición hasta que el vídeo queda descargado. Incluye la espera y la transferencia. Para estimar el cómputo empleado en una generación, usa la tarifa real de tu instancia.
1Coste estimado de generación = precio por hora × segundos de petición ÷ 3.600
2Coste medio de sesión = coste de todo el tiempo facturable ÷ vídeos obtenidos
3
La primera cuenta aproxima el cómputo con la tarifa mostrada; no sustituye al consumo facturado. La segunda incluye el arranque y las pausas entre pruebas. Si enciendes una GPU para un solo clip, esos minutos pueden pesar más que la propia generación. Guarda también las peticiones fallidas: pueden haber consumido cómputo aunque no hayas recibido un archivo.
Desde que pedimos el arranque hasta confirmar el apagado pasaron unos 63 minutos, con pausas para preparar esta guía. Cobrar toda esa ventana a 0,79 €/hora daría una estimación conservadora de 0,83 € por la sesión, unos 0,42 € por vídeo descargado. Es una cuenta a partir del tiempo transcurrido, no una factura. Si generas varios clips seguidos, repartes el arranque entre más resultados.
Al terminar, vuelve a Despliegues, abre la fila de MiniMax-H3 y pulsa Estado del modelo → Apagar modelo. Espera a que aparezca Detenida. Cerrar el navegador o acabar el script no detiene la GPU.
Para futuras sesiones puedes usar una regla de Programación. También existe Serverless, que arranca con las peticiones y se detiene tras un periodo sin tráfico; activarlo elimina las reglas de programación existentes. Un arranque bajo demanda sigue necesitando tiempo para preparar el modelo.
Si algo falla
La ficha oficial de MiniMax-H3 describe un sistema más amplio, con preparación de contexto y regeneración a 2K. Esta guía usa el modelo desplegado en QDivZero y los tamaños del laboratorio; esos servicios adicionales de MiniMax no forman parte de los ejemplos.