
Guía técnica · Despliegue de DeepSeek para equipos
DeepSeek V4.1 Flash 1017Todo tu equipo · 32 usuarios simultáneos
Aprende a desplegar DeepSeek V4.1 Flash 1017 en QDivZero y conectarlo a OpenCode. Ejemplo para 32 usuarios simultáneos, con calculadora de costes.

Contenido de la guía8 secciones
Vamos a desplegar DeepSeek V4.1 Flash 1017 en QDivZero y conectarlo a OpenCode para trabajar sobre un repositorio. Todo el equipo usará el mismo endpoint privado, cada persona con su propia clave API. El modelo admite hasta 1M de tokens de contexto.
Partimos de un despliegue de referencia para 32 usuarios simultáneos, con un precio de 5 €/hora bajo demanda para el despliegue completo. Puede compartirlo un equipo de más de 32 personas si el uso se reparte durante la jornada. La capacidad depende de las GPU, del contexto y del trabajo que le pidas al modelo.
Ocho horas al día durante 22 días laborables salen por 880 €/mes de cómputo. Entre 32 miembros son 27,50 €/mes por persona; entre 64, 13,75 €. En el paso 6 puedes ajustar esa cuenta con la calculadora y programar el encendido y apagado. Al final veremos Serverless y el balanceador para quienes necesiten usarlo fuera de un horario fijo.
1. Prepara la cuenta y la clave API
Necesitas una cuenta de QDivZero con saldo para arrancar las GPU y una clave API de esa cuenta. Usaremos la clave desde la terminal, así que guárdala fuera del repositorio.
En el ordenador o servidor donde trabajas con tu proyecto, ten instalados cURL, Python 3.11 o posterior y OpenCode. Usaremos cURL para la primera llamada y Python para la prueba de carga.
DeepSeek se ejecutará en las GPU de QDivZero. OpenCode estará en tu ordenador o servidor, desde donde leerá los archivos del proyecto, consultará al modelo y ejecutará las herramientas que autorices.
En los ejemplos llamaremos al modelo equipo-codigo. Puedes elegir otro nombre si lo cambias también en las llamadas y en la configuración de OpenCode.
2. Despliega DeepSeek V4.1 Flash 1017
- Abre Despliegues → Lanzar un modelo y elige el catálogo manual.
- Busca
deepseek-ai/DeepSeek-V4.1-Flash-1017, selecciónalo y continúa al paso Pod. - Elige el perfil Profundo para trabajar con análisis y contexto largo. Para seguir el ejemplo con la ventana completa, el contexto del servidor debe ser de
1048576tokens. Si Profundo propone una ventana menor, usa Personalizado → Exigir el contexto completo del modelo. QDivZero calculará la memoria y el número de GPU necesarios. - Activa Modo de planificación → Inteligente para buscar capacidad compatible con el modelo.
- En Región, selecciona solo Europe. Desmarca Sin región y las demás regiones.
- Desactiva Permitir capacidad comunitaria. Para esta primera prueba bajo demanda, deja también desactivada Permitir capacidad interrumpible.
- Fija el Precio máximo por hora que aceptas. La oferta muestra las GPU, la memoria, el proveedor, la ubicación y el coste del despliegue completo.
- En Configuración, pon
equipo-codigocomo nombre del despliegue. Deja Serverless y Conjunto de réplicas desactivados para hacer primero la prueba con una instancia encendida. - En Revisión, escribe también
equipo-codigoen Nombre del modelo. Este campo será el identificador de la API, aunque el nombre visible del despliegue sea otro. - Confirma el despliegue y espera a que el modelo termine de cargar.
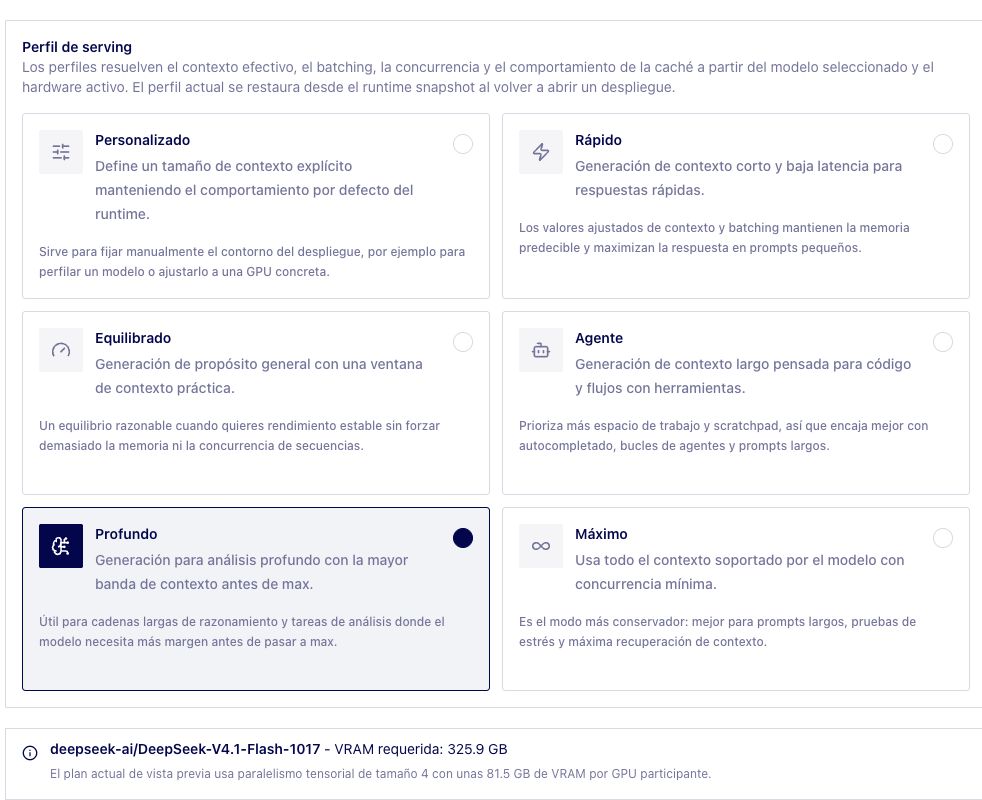
Aunque el modelo ocupe varias GPU, todo el equipo lo usa desde un solo endpoint. QDivZero prepara el servidor de inferencia, reparte el modelo y configura las llamadas a herramientas de DeepSeek. Los pesos se comparten en memoria y cada persona conserva su conversación en su cliente.
La ficha del modelo publica la licencia MIT y una ventana de 1M de tokens (1.048.576). Los ejemplos de OpenCode usan esa ventana para poder enviar código, documentación e historial de herramientas. Mantener conversaciones largas consume más memoria, sobre todo cuando coinciden varias. Al exigir el contexto completo puede cambiar la oferta necesaria; usa el precio que muestre el asistente para calcular tu coste.
Mantener el despliegue en Europa
La infraestructura de la plataforma QDivZero está en Europa. El filtro Europe limita además la ubicación de las GPU que ejecutan tu modelo y se conserva cuando el planificador busca capacidad para volver a arrancarlo.
Usaremos Chat Completions. QDivZero no retiene logs del contenido de esas llamadas ni utiliza tus prompts o el código enviado para entrenar modelos. Los registros de consumo, facturación y seguridad se gestionan según la política de privacidad. OpenCode guarda su historial según su propia configuración.
Si quieres probar una instancia spot
Al activar Permitir capacidad interrumpible, el planificador también busca ofertas spot. La oferta elegida puede seguir siendo bajo demanda, así que el tipo de capacidad aparece en el resumen de la selección.
El proveedor puede reclamar una máquina spot. QDivZero intenta relanzarla, pero buscar capacidad y cargar el modelo lleva tiempo. Durante ese intervalo tendrás que esperar o contar con otro destino disponible. El paso 8 explica cómo añadir ese respaldo.
3. Haz la primera llamada a DeepSeek
Abre una terminal y pega este bloque con tu clave en lugar de TU_CLAVE_API_DE_CUENTA.
1export QDIV0_API_URL='https://api.qdiv0.com'
2export QDIV0_API_KEY='TU_CLAVE_API_DE_CUENTA'
3export QDIV0_MODEL='equipo-codigo'
4
5curl --fail-with-body --silent --show-error --max-time 900 \
6  "${QDIV0_API_URL}/v1/chat/completions" \
7  -H "Authorization: Bearer ${QDIV0_API_KEY}" \
8  -H 'Content-Type: application/json' \
9  --data-binary @- <<JSON
10{
11  "model": "${QDIV0_MODEL}",
12  "messages": [
13    {"role": "user", "content": "Escribe una funcion Python add(a, b) y dos asserts. Sin explicacion."}
14  ],
15  "max_tokens": 4096,
16  "stream": false
17}
18JSON
19
La respuesta llegará en un JSON. Dentro de choices[0].message encontrarás el mensaje del asistente con la función y los dos assert que le has pedido.
Si falla, empieza por el estado de la instancia y la cuenta a la que pertenece la clave. El campo Nombre del modelo debe ser equipo-codigo, igual que en la llamada. Una respuesta con finish_reason: "length" indica que se agotó el límite de salida, que también puede incluir razonamiento. En ese caso, aumenta max_tokens dentro de lo que admita el servidor.
4. Conecta DeepSeek a OpenCode
En la raíz del proyecto, crea un archivo opencode.json con este contenido. Si ya tienes uno, incorpora esta configuración al archivo existente.
1{
2  "$schema": "https://opencode.ai/config.json",
3  "model": "qdivzero/equipo-codigo",
4  "enabled_providers": ["qdivzero"],
5  "provider": {
6    "qdivzero": {
7      "npm": "@ai-sdk/openai-compatible",
8      "name": "QDivZero",
9      "options": {
10        "baseURL": "https://api.qdiv0.com/v1",
11        "apiKey": "{env:QDIV0_API_KEY}"
12      },
13      "models": {
14        "equipo-codigo": {
15          "name": "DeepSeek V4.1 Flash 1017",
16          "limit": { "context": 1048576, "output": 4096 }
17        }
18      }
19    }
20  }
21}
22
Descargar opencode.json · Descargar la prueba Python · Instrucciones de los ejemplos
OpenCode leerá la clave desde QDIV0_API_KEY mediante {env:QDIV0_API_KEY}. Puedes compartir este JSON con el equipo porque solo contiene la URL, el nombre del modelo y sus límites.
El campo context declara la ventana de 1M de tokens y output limita cada respuesta a 4.096 tokens en este ejemplo. El contexto incluye la entrada y la salida, así que parte de esa ventana queda reservada para responder. El despliegue de QDivZero debe tener habilitado el mismo contexto. OpenCode documenta las demás opciones en proveedores personalizados y variables de entorno.
Vuelve a la terminal del paso anterior, entra en la raíz de tu proyecto e inicia OpenCode.
1opencode
2
Abre /models y selecciona DeepSeek V4.1 Flash 1017 bajo QDivZero. Puedes empezar con algo como «Lee esta función, explica por qué falla y propón un cambio con una prueba». Verás qué archivos lee y qué cambios propone. Antes de quedarte con el cambio, revisa el diff y ejecuta la prueba. OpenCode trabaja en el equipo donde lo has instalado, con los permisos que le hayas dado.
5. Da acceso al equipo y prueba la carga
Las personas que compartan este despliegue deben tener acceso a la misma cuenta de QDivZero. Cada una utilizará su propia clave API revocable.
Comparte opencode.json con el equipo. Cada persona configura su QDIV0_API_KEY y abre OpenCode desde su proyecto. Todos usan equipo-codigo y conservan el historial y las herramientas de su agente en su propio cliente.
Antes de incorporar a todo el equipo, puedes enviar varias peticiones a la vez con probe_endpoint.py. Descárgalo y abre una terminal en la carpeta donde lo guardaste, con las variables del paso 3. Empieza con una petición, espera el resultado y sigue con cuatro. Si todo va bien, pasa a 32.
1python3 probe_endpoint.py --requests 1 --concurrency 1
2python3 probe_endpoint.py --requests 4 --concurrency 4
3python3 probe_endpoint.py --requests 32 --concurrency 32
4
El script muestra tiempos, errores y tokens cuando el servidor los devuelve, sin imprimir el contenido de las respuestas. Con --max-tokens 4096 puedes darle más margen de salida. La opción --tools le pide a DeepSeek una llamada a una herramienta de prueba y muestra si la devuelve, sin ejecutarla.
Estas peticiones son cortas y te sirven como primera prueba de conexión y espera. Para saber cómo se comportará durante la jornada, necesitarás también tareas de tu repositorio con contextos parecidos a los del equipo. Ahí verás cuánto tarda en responder y si aparecen errores al aumentar la carga.
Si necesitas más capacidad sostenida, Conjunto de réplicas mantiene el número de instancias que configures con planificación inteligente. Cada réplica añade su coste. Esta opción no se combina con Serverless ni aumenta el número de réplicas automáticamente según la carga.
6. Programa el horario y calcula el coste
Si trabajáis de nueve a cinco, puedes encender las GPU durante esa franja. En Configuración, deja Serverless desactivado y abre Programación. Estas dos reglas arrancan y detienen el despliegue de lunes a viernes, con zona horaria Europe/Madrid.
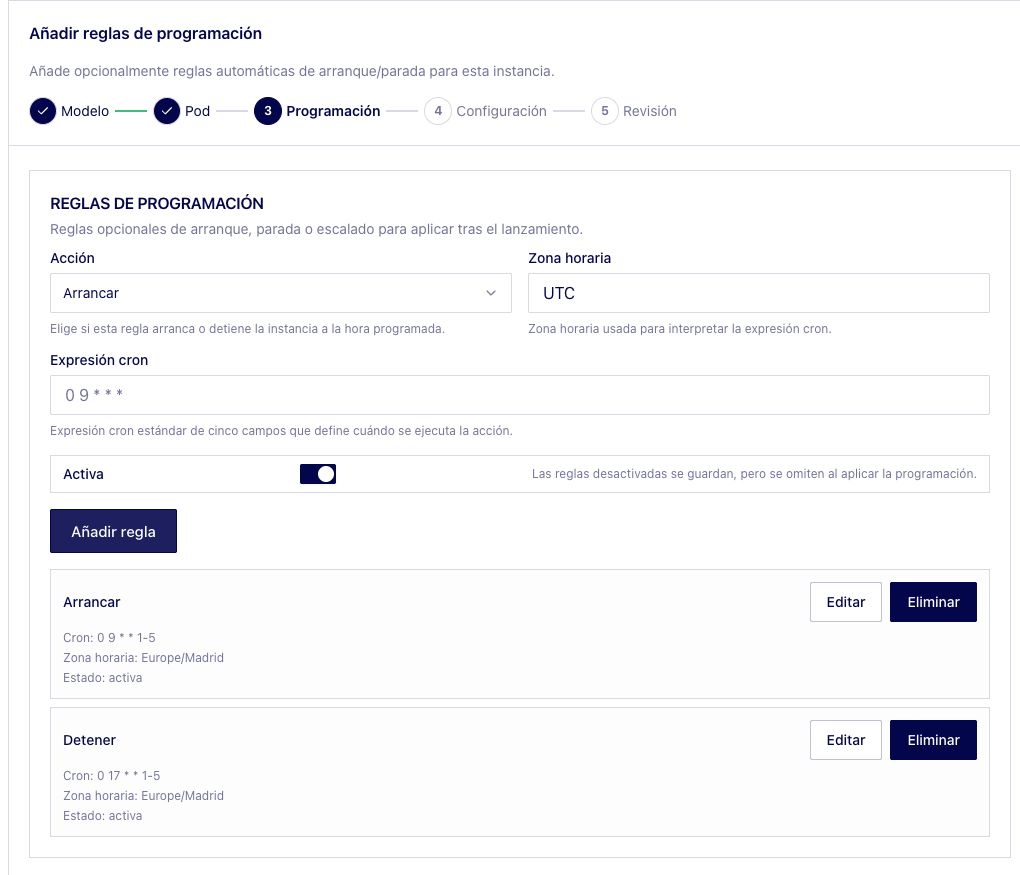
DeepSeek tarda en cargar, así que conviene adelantar el arranque si quieres tenerlo listo a las nueve. Ese tiempo también se factura. La zona Europe/Madrid sigue los cambios de hora y las reglas semanales se ejecutan también en festivos. Si dejáis agentes trabajando después de las cinco, necesitarán un horario más amplio.
Con los 5 €/hora de referencia para todo el despliegue, pagarías lo siguiente según el tiempo que lo mantengas encendido.
El coste por persona se divide entre todos los miembros que lo comparten. Añadir miembros reduce ese reparto, pero las GPU siguen teniendo la misma capacidad. Si más personas trabajan a la vez, tendrás que valorar una oferta mayor o añadir réplicas.
Para tu presupuesto, usa el precio de la oferta que elijas, incluye el tiempo de arranque entre las horas facturadas y suma el almacenamiento y los demás conceptos que indique. Tienes el detalle en las opciones de precio de QDivZero.
Para comparar con otras herramientas hay que sumar la licencia y el consumo de chat y agentes. En este despliegue privado de QDivZero, el cómputo se paga por horas de GPU. La capacidad contratada determina cuánto trabajo puedes procesar durante ese tiempo.
Copilot Business aporta 1.900 AI Credits al mes por licencia a una bolsa compartida. El chat y los agentes consumen créditos según el modelo y los tokens de entrada, salida y caché. Al agotarlos, el uso adicional se cobra si está permitido. El autocompletado y las sugerencias de edición siguen siendo ilimitados en los planes de pago.
En los planes actuales de Cursor Teams, el cupo incluido cubre sus propios modelos. Cuando eliges directamente uno de terceros, se factura desde la primera petición por tokens, con un recargo de Teams de 0,25 USD por millón de tokens. La calculadora suma a la cuota el gasto adicional que indiques después de descontar el uso incluido de cada servicio.
¿Cuánto cuesta compartir el despliegue?
Indica cuántos sois y cuántas horas usaréis DeepSeek. El precio por hora corresponde al despliegue completo.
La referencia es de 32 usuarios simultáneos. Añadir miembros reparte la factura entre más personas; la capacidad de las GPU sigue siendo la misma. El contexto y las tareas también influyen en la concurrencia.
Consumo adicional de chat y agentes
Indica el gasto mensual medio por tokens que se factura aparte de cada licencia, por persona y después de descontar el uso incluido. Puedes usar el importe de tu panel de facturación. El modelo, la entrada, la salida y la caché influyen en la cuenta.
Con el consumo adicional a cero, Cursor y Copilot muestran solo la cuota base. El uso incluido tiene límites.
Las otras curvas suman la licencia y el gasto por tokens que has indicado. QDivZero reparte el cómputo entre el equipo.
- QDivZero
- Cursor Teams Premium
- GitHub Copilot Business
1 USD = 0.90 EUR. Usamos un cambio de ejemplo que puedes editar. No se actualiza en tiempo real.
Supuestos de la comparación
Puedes poner los precios de tu contrato y el cambio de moneda que quieras usar.
| Proveedor | Supuesto de precio base | Extra USD / persona / mes | Equipo / mes | Miembro / mes |
|---|---|---|---|---|
| QDivZeroCómputo DeepSeek 1017 | 5 EUR / hora del despliegue | Cubierto por el cómputo | 880,00 € | 13,75 € |
| Cursor Teams PremiumSolo cuota base | $30 USD / puesto / mes | $0 | 1728,00 € | 27,00 € |
| GitHub Copilot BusinessSolo cuota base | $19 USD / puesto / mes | $0 | 1094,40 € | 17,10 € |
El cálculo de QDivZero cubre el cómputo. Incluye el tiempo de arranque en las horas activas; suma el almacenamiento y los impuestos aparte. El consumo adicional depende de los modelos elegidos, los créditos incluidos y los permisos de gasto. Estos servicios tienen prestaciones y límites de uso diferentes.
Precios y reglas de facturación consultados el . Fuente de precios de Cursor ($30 USD), Fuente de precios de GitHub ($19 USD). Facturación por tokens en Cursor · GitHub Copilot.
7. Arranca DeepSeek bajo demanda con Serverless
Con Serverless, una petición puede encender el modelo y un periodo sin tráfico lo apaga. Es útil si los horarios del equipo cambian o hay días en los que apenas lo usáis.
- Abre Configuración de tu despliegue.
- Deja Conjunto de réplicas desactivado y activa Serverless. Al hacerlo, se eliminan las reglas de horario de esa instancia.
- Pon
900en Tiempo de inactividad (segundos) y guarda. Son 15 minutos sin tráfico. Si pones0, desactivas la parada automática.
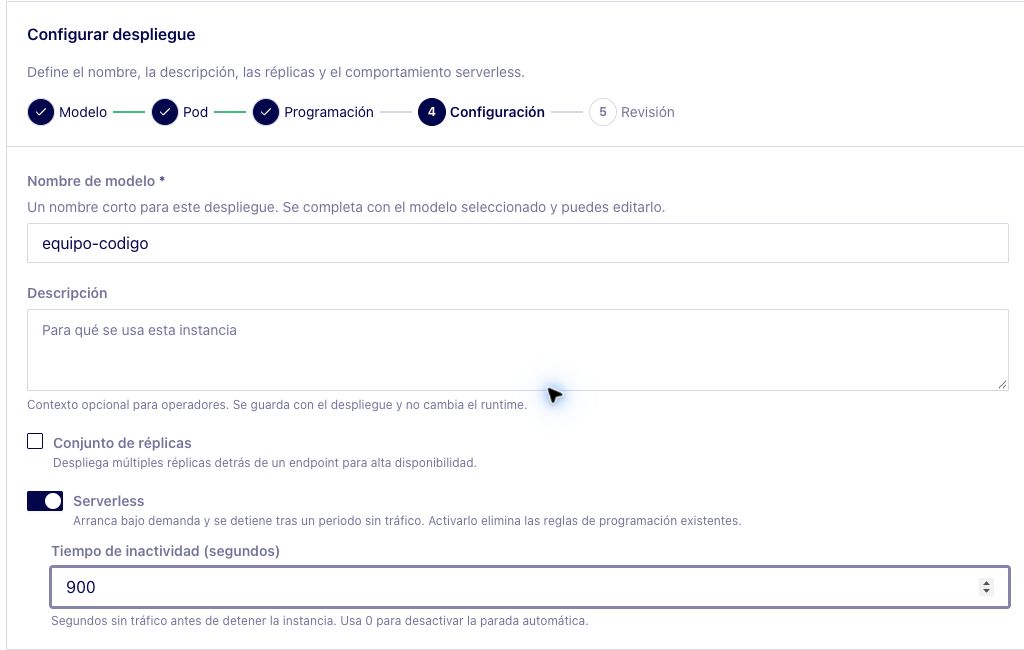
Cuando la instancia esté detenida, envía la llamada del paso 3. La petición directa puede quedar esperando durante el arranque. El ejemplo de cURL permite esperar hasta 900 segundos, que puedes ampliar si el modelo necesita más tiempo para cargar.
Mientras OpenCode ejecuta pruebas o herramientas puede pasar un rato sin llamar al modelo. Si las GPU se apagan en esas pausas, aumenta el tiempo de inactividad.
Con Serverless, el presupuesto depende de las horas realmente facturadas, incluidos los arranques que provoquen peticiones fuera de horario. Cada búsqueda de capacidad puede devolver otro precio. El Precio máximo por hora pone un techo a las ofertas que aceptas, pero el total mensual depende de cuánto tiempo estén encendidas las GPU.
8. Añade un Smart Balancer para DeepSeek si necesitas un respaldo
Un Smart Balancer permite repartir las peticiones entre varios despliegues de DeepSeek V4.1 Flash 1017. El equipo sigue usando el mismo nombre de modelo, aunque cambies las instancias que hay detrás. Empieza creando la ruta a la instancia que ya tienes.
- Abre Smart Balancers → Crear Smart Balancer.
- Pon
equipo-agentescomo nombre visible, elige carga Chat y modo Prioridad. Así las rutas siguen el orden que configures. - En Routing, llama a la ruta
deepseek-1017, elige tipo Instancia y selecciona tu despliegue de DeepSeek. - En Revisión, usa
equipo-agentescomo Nombre del modelo y tu instancia como destino. Guarda el balanceador. - Con la instancia encendida, repite la llamada del paso 3 cambiando
QDIV0_MODELaequipo-agentes.
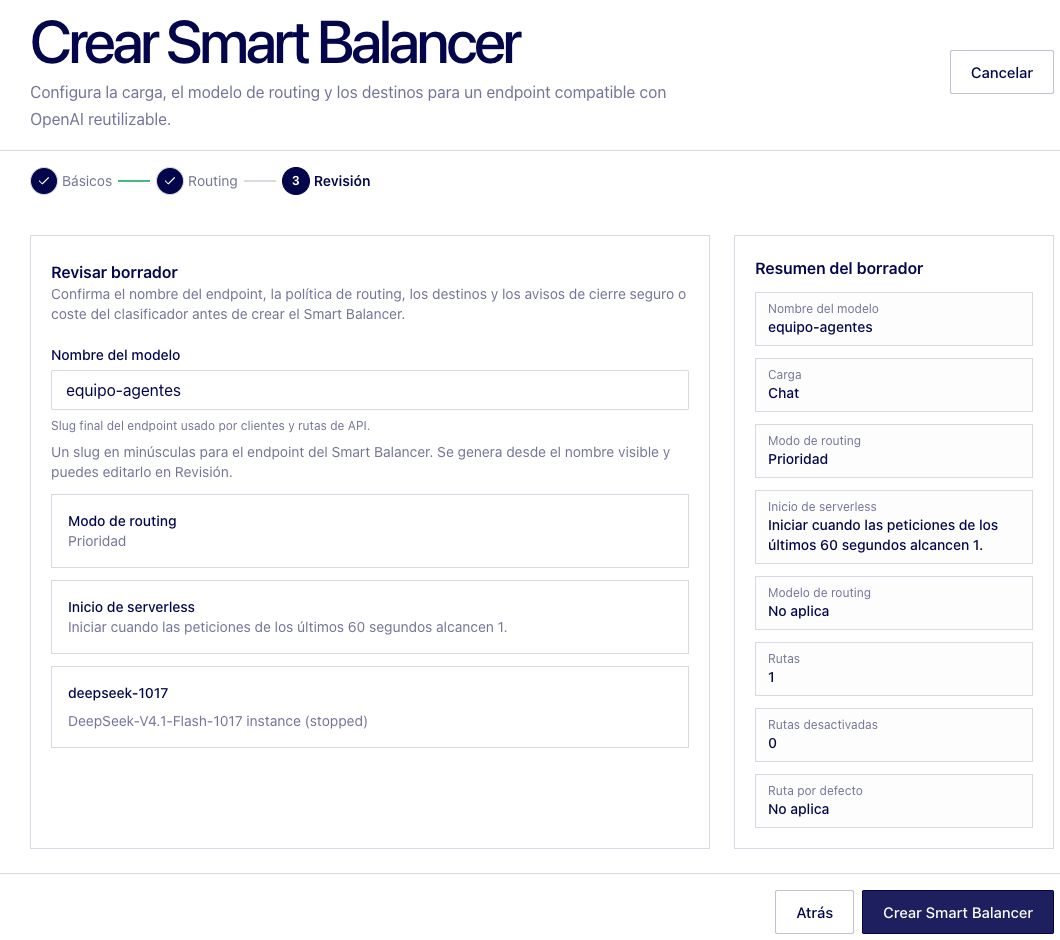
Cuando recibas la respuesta, cambia equipo-codigo por equipo-agentes tanto en el campo model como en la clave dentro de models de opencode.json. El equipo puede usar ese archivo con las mismas claves API y URL base.
Para atender peticiones mientras carga una instancia Serverless, añade como segunda ruta otra instancia privada de la misma revisión, también con el filtro Europe. Esa instancia debe estar disponible y su coste se suma al presupuesto. Un valor de 1 en Peticiones para iniciar serverless y una Ventana móvil de 60 segundos solicitan el arranque con la primera petición. Mientras carga, responde la instancia de respaldo.
Puedes ensayar el cambio deteniendo la instancia principal y enviando una petición. Verás qué destino la atiende mientras vuelve a arrancar. Cuando esté disponible, las nuevas peticiones regresarán a la primera ruta. Las respuestas que ya se están generando terminan en el destino que las recibió. Si una se interrumpe, mira qué acciones llegó a ejecutar el agente antes de repetir la tarea.