Guía técnica · Modelos privados para ciberseguridad
Ciberseguridad con IARevisa PHP, prueba un parche y analiza accesos SSH
Despliega un modelo abliterated para ciberseguridad en QDivZero. Guía paso a paso con código, pruebas de SQL y PHP, análisis SSH y costes de cómputo.

Contenido de la guía7 secciones
Probamos un modelo privado de IA en QDivZero con tres tareas de ciberseguridad. Reprodujimos una inyección SQL, analizamos siete eventos SSH y compilamos un parche que propuso para PHP. En este último caso necesitó dos intentos; la primera respuesta no servía.
Aquí tienes los pasos para repetirlo, con código, respuestas originales y capturas. SQL y SSH son ejercicios de laboratorio; PHP usa código original de la versión 8.2.34 y pruebas ejecutadas en contenedores locales.
El 21 de octubre de 2026, la capacidad asignada costaba 0,41 €/h. Entre las dos sesiones mantuvimos el despliegue encendido unos 45 minutos, unos 0,31 € de cómputo estimado. Ese tiempo incluye arranque y pausas; no es un precio por consulta.
1. Descarga los archivos
Necesitas una cuenta de QDivZero con saldo y Python 3.11 o posterior. Descarga laboratorio.zip, descomprímelo y abre una terminal en esa carpeta. No hace falta instalar paquetes.
El cliente envía texto y guarda respuestas. sql_lab.py ejecuta la prueba SQL en tu ordenador. Para recompilar PHP necesitas además Docker y el entorno de php-liferaft del apartado 5. Los tres casos son independientes; puedes empezar por SQL o SSH y dejar la compilación para después.
2. Despliega y enciende el modelo
Usamos hotdogs/Qwen3.8-27B-abliterated-MTP-GGUF, una versión de Qwen 3.8 27B publicada por la comunidad. Su repositorio indica licencia Apache 2.0.
- Abre Despliegues → Desplegar modelo → Elegir manualmente y busca ese repositorio.
- En Seleccionar cuantización GGUF → Q4_K_M, elige
Qwen3.8-27B-abliterated-mtp-Q4_K_M-mixed.gguf. - En Pod, selecciona Personalizado → Permitir contexto reducido y escribe
8192. Los archivos de estos ejercicios caben en esa ventana. - Mantén la planificación Inteligente. Para usar solo capacidad europea, marca Europe y desmarca Sin región. En nuestra prueba dejamos desactivadas la capacidad comunitaria y la interrumpible.
- Fija el Precio máximo por hora. Nosotros pusimos
1 €/h; es un límite de tarifa, no un presupuesto total. En Programación, añade una regla Detener para el final de la sesión. - En Configuración, pon
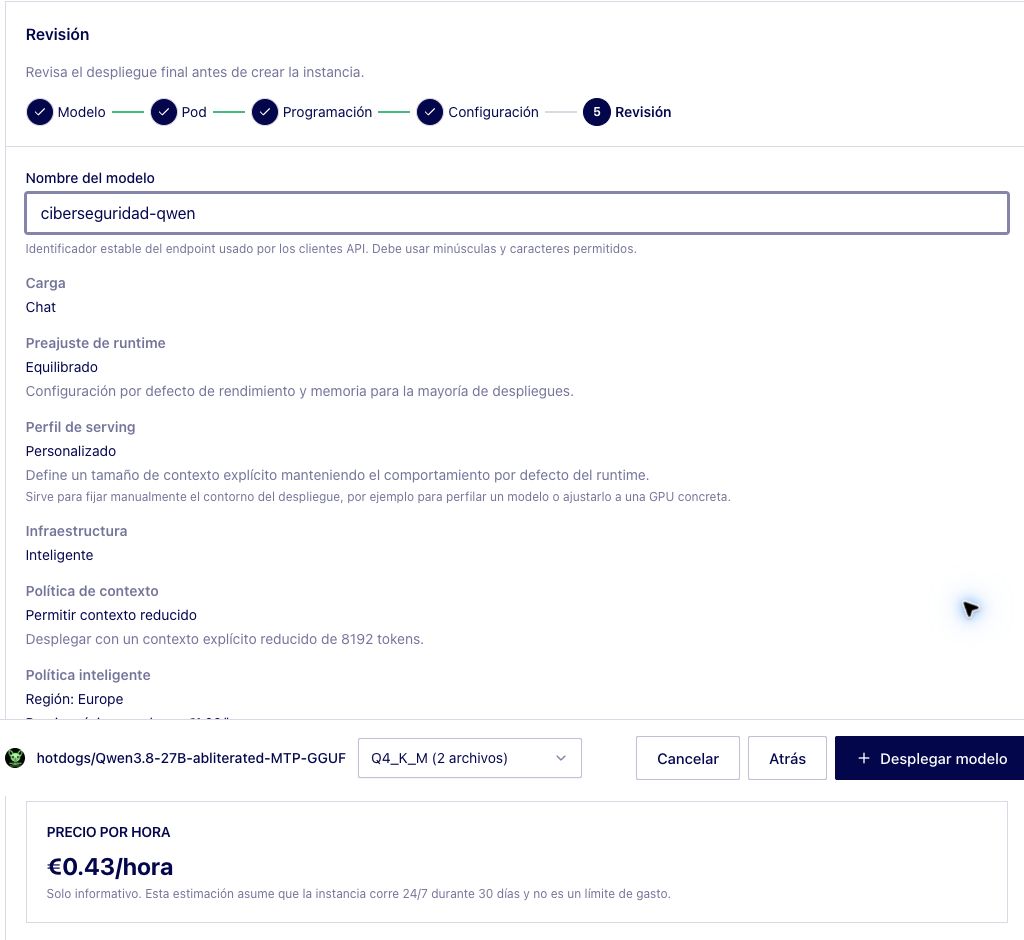
Guía de ciberseguridadcomo nombre visible. Deja Serverless y el conjunto de réplicas desactivados. - En Revisión → Nombre del modelo, escribe
ciberseguridad-qwen. Es el identificador que usará el cliente Python. - Pulsa Desplegar modelo. Abre su fila y elige Estado del modelo → Iniciar modelo.
No iniciada significa que el despliegue está creado pero apagado. Mientras aparezca Pendiente, espera a que termine el arranque.
Abliterated se refiere a una modificación de los pesos que reduce los rechazos del modelo. El trabajo sobre la dirección de rechazo explica la técnica. Esto no aporta por sí mismo conocimientos nuevos de ciberseguridad.
El archivo GGUF elegido ocupa unos 17,8 GB. QDivZero lo ejecuta con llama.cpp y necesita memoria adicional para el contexto y el runtime. Aunque el nombre incluye MTP, el runtime revisado para esta guía no activa automáticamente esa decodificación especulativa.
3. Envía la primera petición
Con el modelo encendido, abre Desarrolladores → Chat y selecciona ciberseguridad-qwen. Deja vacío Mensaje del desarrollador y pon Pensamiento → Desactivado.
Envía este mensaje.
1Responde únicamente con la palabra LISTO.
2
Cuando recibas LISTO, el endpoint ya responde. Para usarlo desde la terminal, crea una clave API y exporta estas variables.
1export QDIV0_API_KEY='TU_CLAVE_API'
2export QDIV0_ACCOUNT_ID='ID_DE_TU_CUENTA'
3
Encontrarás el ID en Desarrolladores → Ver código, en la cabecera X-Account-Id. El cliente llama a https://api.qdiv0.com/v1/chat/completions con el nombre ciberseguridad-qwen.
Los comandos siguientes muestran la respuesta en la terminal y guardan un JSON en resultados. Si repites un ejercicio, cambia el nombre del archivo de salida para conservar el anterior. El cliente envía un único mensaje de usuario, con reasoning_effort: "none" y un máximo de 3072 tokens de salida. Si la respuesta queda cortada, avisa en la terminal y marca truncated en el JSON.
Las respuestas publicadas se obtuvieron en el chat de QDivZero, pegando los mensajes guardados en prompts/. El cliente del ZIP permite repetir esas peticiones por API; lo validamos con pruebas HTTP locales. En el chat usamos streaming para ver la respuesta mientras llegaba; el script usa stream: false y espera el JSON completo.
Si usas otro nombre de servicio al desplegar, añade export QDIV0_MODEL='tu-nombre'. El nombre visible de la fila no sustituye a ese identificador. Un error de disponibilidad se resuelve revisando el estado del despliegue antes de volver a enviar la petición; el script no reintenta automáticamente.
4. Red team con una inyección SQL
El primer archivo contiene dos versiones de una búsqueda por nombre, una con interpolación y otra parametrizada. Enviamos ambas al modelo para que propusiera una entrada y predijera el resultado de cada versión. Esta es la vulnerable, extraída de cases/code_review.py.txt.
1def find_customer(connection, name):
2    query = (
3        "SELECT id, name, email FROM customers "
4        f"WHERE name = '{name}'"
5    )
6    return connection.execute(query).fetchall()
7
La interpolación f"WHERE name = '{name}'" inserta lo que recibe la función dentro de la consulta. Una búsqueda de Alice funciona, pero el apóstrofo de O'Connor ya rompe esa construcción. Para demostrar una inyección necesitamos además una entrada que cambie qué filas devuelve.
La petición pide una demostración mínima en SQLite en memoria, con dos clientes, y el resultado esperado al usar la misma entrada en la consulta parametrizada. Puedes leerla en prompts/redteam.txt y enviarla junto al código con este comando.
1python3 review_security.py --case redteam --output resultados/redteam.json
2
En nuestra prueba, el modelo devolvió un programa Python con una demostración en memoria. Puedes descargar la respuesta original. La entrada que utilizó fue esta.
1' OR 1=1 --
2
Al sustituir name, la consulta queda así. OR 1=1 hace verdadera la condición de todas las filas y -- comenta la comilla que añade la función al final.
1SELECT id, name, email FROM customers WHERE name = '' OR 1=1 -- '
2
Ejecutamos la misma entrada en el laboratorio del ZIP. Puedes repetir la prueba sin arrancar el modelo ni gastar cómputo en QDivZero.
1python3 sql_lab.py
2
Crea una base SQLite en memoria con dos clientes, Alice y O'Connor, y pasa la misma entrada a la función vulnerable y a la corregida. La salida es esta.
1{
2  "database": ":memory:",
3  "proof_input": "' OR 1=1 -- ",
4  "vulnerable_rows": 2,
5  "parameterized_rows": 0
6}
7
La búsqueda ha devuelto a Alice y a O'Connor, aunque no le hemos pedido ninguno de esos nombres. Son las 2 filas de vulnerable_rows. La función parametrizada devuelve 0 porque busca el texto completo como un nombre y no encuentra a nadie.
La función corregida usa el marcador ? de SQLite y pasa el nombre como una tupla de un elemento.
1def find_customer(connection, name):
2    query = "SELECT id, name, email FROM customers WHERE name = ?"
3    return connection.execute(query, (name,)).fetchall()
4
SQLite recibe la consulta y el valor por separado. El contenido de name ya no puede convertirse en una condición SQL. El laboratorio también prueba una búsqueda legítima de O'Connor y otra de un nombre inexistente.
El programa verifica esos resultados con aserciones y cierra la base al terminar.
5. Un caso de PHP, del código al parche
Esta prueba surgió del análisis sobre session.upload_progress y del trabajo de backports de php-liferaft.
Durante esta prueba, la mañana del 21 de octubre de 2026, el aviso oficial de PHP situaba la publicación de dos correcciones críticas a las 16:00 de Madrid, 14:00 UTC. El artículo atribuía el problema a dos CVE; esa atribución y la cadena de explotación seguían pendientes de contraste. Tomamos como punto de partida un contador incorrecto que reproducimos en PHP 8.2.34.
La subida terminaba con un contador incorrecto
Subimos dos archivos de prueba y, después, un campo de formulario grande. El cuerpo completo tiene 262.642 bytes, pero el progreso guardado en la sesión termina en 136.576. La subida acaba bien y los tamaños de los archivos son correctos. El contador final se ha quedado atrás.
Para buscar la causa, usamos un fragmento del código C original, anterior al parche. Está en cases/php82_session_excerpt.c.txt, dentro del ZIP. Conserva las ubicaciones originales mediante #line e incluye partes de session.c y php_session.h; es una selección de código, no un archivo que se pueda compilar por separado.
El cuerpo multipart llevaba un archivo de 131.072 bytes, otro de 31 y un campo posterior de 131.072 bytes. Los separadores y cabeceras completaban los 262.642 bytes. Para conservar el resultado en la sesión y actualizarlo con frecuencia usamos estos valores.
1session.upload_progress.cleanup=0
2session.upload_progress.freq=1
3session.upload_progress.min_freq=0
4
Con cleanup=0 el progreso permanece en la sesión al terminar. La prueba exige que done=true y que bytes_processed coincida con la longitud completa del cuerpo.
Seleccionamos 155 líneas del archivo oficial de PHP 8.2.34. En ext/session/php_session.h:136 se declara post_bytes_processed como un puntero a zval. En ext/session/session.c:3091 se guarda la dirección del campo del array. El bloque final, en las líneas 3163–3166, separa el array y después escribe mediante ese puntero. El fragmento enviado también conserva el incremento de referencia de las líneas 2988–2989; omitirlo habría alterado el análisis de la vida del array.
Dos peticiones y una primera respuesta descartada
La primera revisión, sin darle el resultado de la prueba, salió mal. Sugirió una fuga de memoria sin demostrarla y propuso un test que daría OK antes y después. Guardamos esa primera respuesta y la descartamos.
La tarea de esa primera petición empezaba así; el mensaje completo, con el código numerado, está en prompts/php.txt.
1Review these selected C source excerpts from PHP 8.2.34.
2Identify a concrete defect supported by the code, cite the original
3file and line numbers, and trace the operations that cause it.
4
Puedes repetirla por separado y conservar ambos resultados.
1python3 review_security.py --case php --output resultados/php-primera.json
2
Repetimos la petición en una conversación nueva. Esta vez le damos el código y los datos de la regresión, sin mostrarle el parche de referencia.
1python3 review_security.py --case php-counter --output resultados/php.json
2
prompts/php-counter.txt añade las medidas, los ajustes de PHP y los tamaños correctos de los archivos. Pide un diff mínimo que preserve progreso, limpieza y cancelación. El modelo recibe el síntoma medido, pero ninguna petición incluye el artículo, los CVE ni el parche de referencia.
El modelo señala SEPARATE_ARRAY(&progress->data). Esa operación puede copiar el array, pero post_bytes_processed conserva la dirección de un campo del array anterior. La escritura del contador termina en esa copia anterior, mientras se publica la nueva.
Su propuesta es volver a buscar el campo después de separar el array y antes de escribir el valor final.
1SEPARATE_ARRAY(&progress->data);
2progress->post_bytes_processed = zend_hash_str_find(
3    Z_ARRVAL(progress->data), "bytes_processed",
4    sizeof("bytes_processed") - 1);
5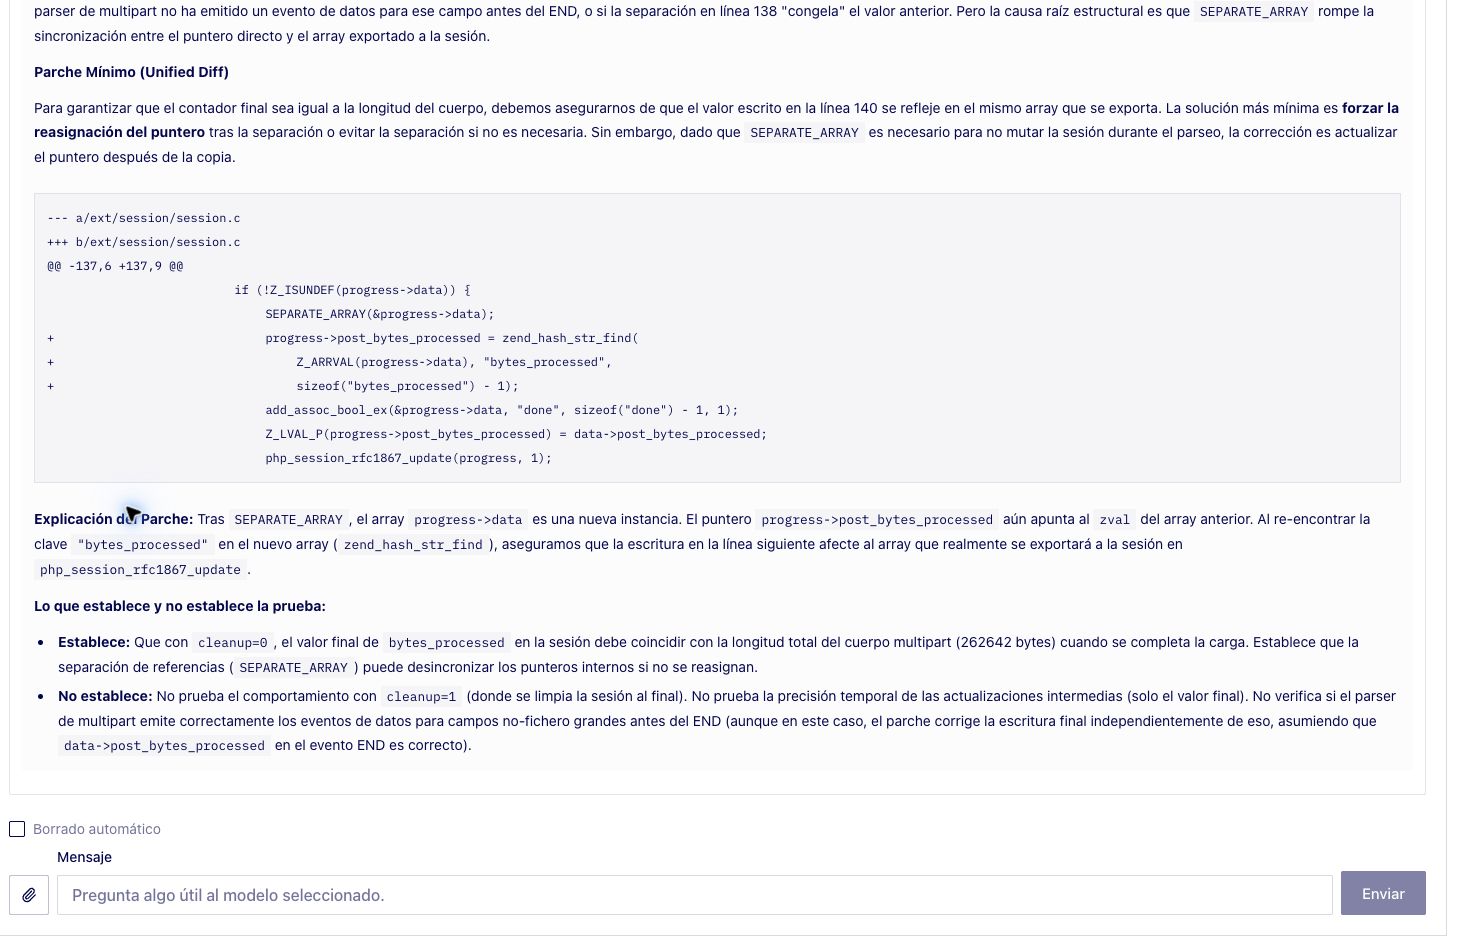
Puedes descargar la respuesta completa y el parche preparado para aplicar. La explicación también especula con que el parser no cuente el último campo; la prueba no respalda esa parte.
Aplicación del parche y resultado de la prueba
El diff original apuntaba a la línea 137 del fragmento en vez de a la 3161 del archivo completo. Corregimos las cabeceras y la sangría, conservando las tres líneas de C propuestas. Desde la raíz del código original de PHP, con el parche descargado en esa carpeta, se aplica así.
1patch --dry-run --batch --fuzz=0 -p1 -i php-counter-proposal.patch
2patch --batch --fuzz=0 -p1 -i php-counter-proposal.patch
3
Para compilar usamos el SDK local de php-liferaft correspondiente al mismo runtime y arquitectura. El script del proyecto compara la identidad ABI del código con la del SDK antes de compilar. Dentro de ese contenedor, en ext/session, ejecuta estos comandos.
1phpize
2export CFLAGS="-O2 -g -fcommon"
3./configure --with-php-config=/usr/local/bin/php-config --enable-session=shared
4make -j 4
5
El resultado es modules/session.so. Para repetir esta parte necesitas construir el SDK y los runtimes del commit usado en la prueba; los comandos anteriores presuponen ese entorno. El ZIP contiene el parche y los resultados, pero no incluye un módulo binario intercambiable con cualquier instalación de PHP.
Cargamos solo el nuevo session.so en el runtime original y repetimos la misma subida.
Se repitió con los serializadores php, php_binary y php_serialize. También pasaron las pruebas de subidas normales, limpieza y cancelación. Los parámetros y resultados están en php-regression.json; el proyecto de referencia contiene el entorno de compilación y sus pruebas.
Esta comprobación demuestra la corrección del contador en ese caso. No demuestra una ejecución remota de código ni convierte la propuesta en el parche oficial de PHP. Para actualizar un servidor, contrasta el aviso oficial y la versión que utiliza tu aplicación. El parche independiente de php-liferaft tiene un alcance distinto: elimina los punteros persistentes a los contadores, en lugar de refrescar uno al final.
6. Blue team con un registro SSH
Para el análisis de logs preparamos cases/ssh_events.log con siete eventos ficticios. Incluimos fallos y un acceso correcto desde la misma IP, además de un acceso con clave pública desde otra dirección. Así podemos ver si el modelo conserva los detalles y si confunde una secuencia sospechosa con un incidente confirmado.
La petición de prompts/logs.txt pide una cronología con horas e IP, hechos separados de hipótesis y las evidencias que habría que obtener después. También pide que no atribuya un país, reputación o CVE a las direcciones. El comando envía únicamente esas instrucciones de la tarea y las líneas del registro, dentro del mensaje de usuario.
1python3 review_security.py --case logs --output resultados/ssh.json
2
El modelo relacionó los fallos con el acceso posterior de backup. También señaló que faltaba saber si ese acceso estaba previsto y qué se hizo durante la sesión. Puedes descargar su análisis completo.
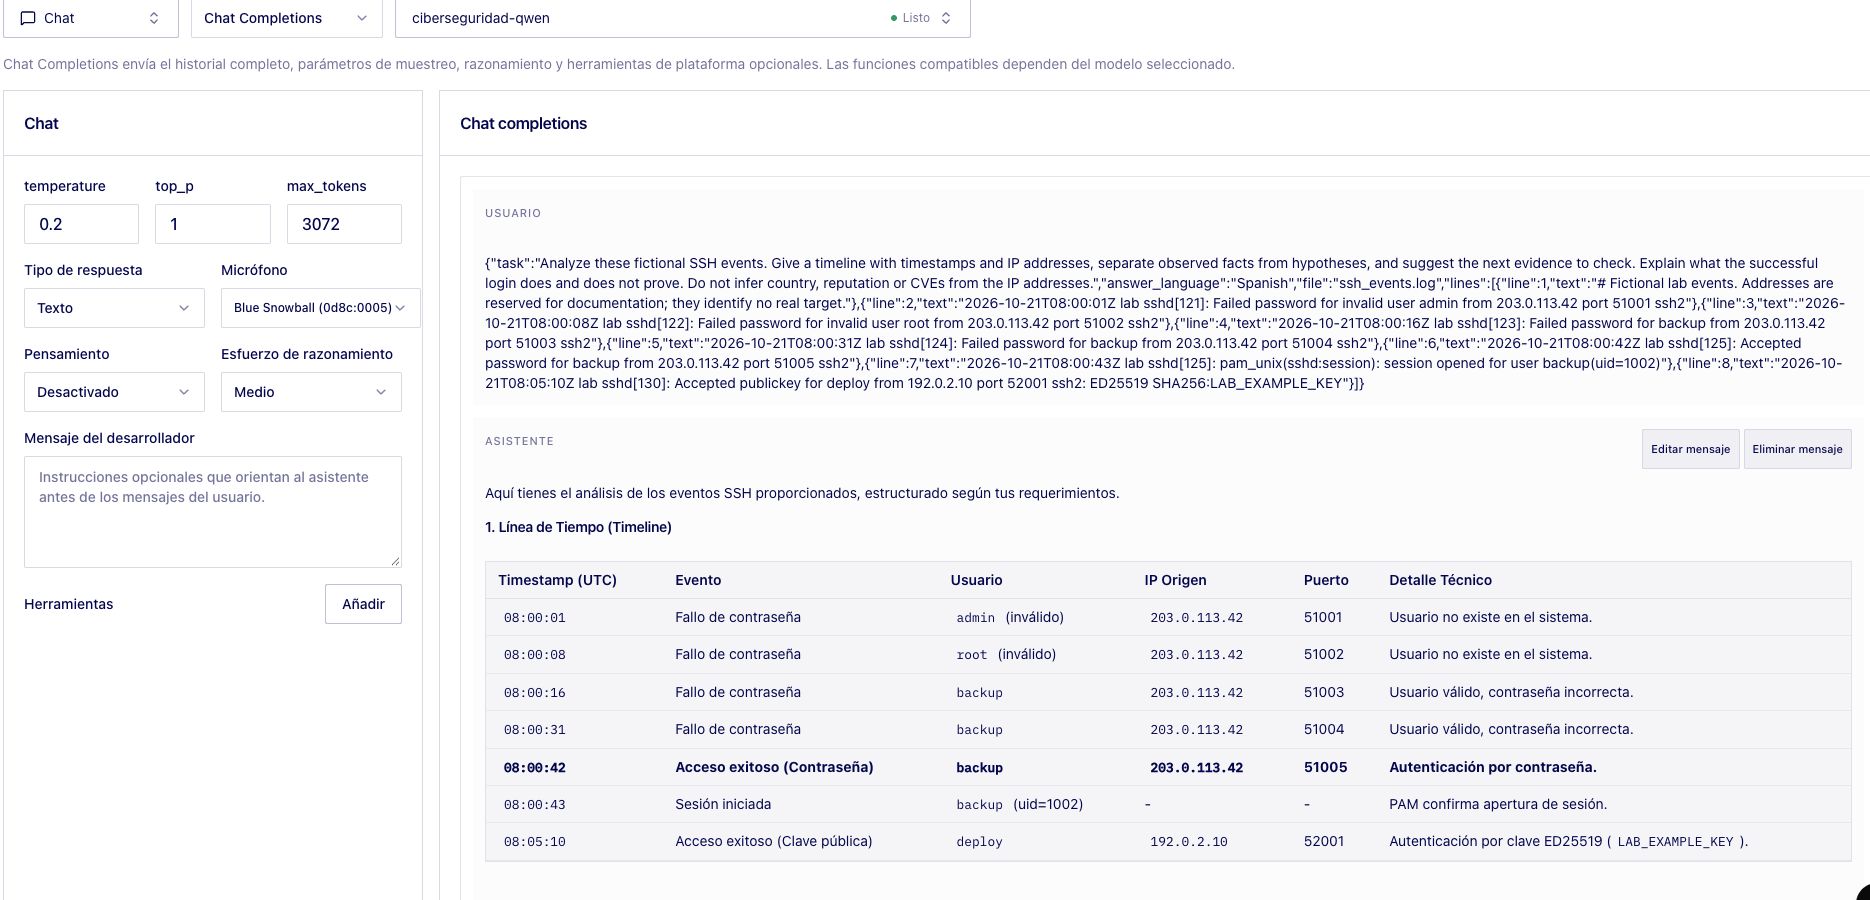
Los eventos de las 08:00:42 y 08:00:43 comparten el PID 125. Eso permite relacionar la contraseña aceptada con la apertura de sesión de backup. Los intentos anteriores tienen otros PID. El archivo no demuestra que alguien haya adivinado la contraseña; también encaja con errores de un usuario legítimo. El acceso de deploy viene de otra IP y no hay datos que lo relacionen con el de backup.
Para investigar un caso equivalente pediríamos al responsable de backup que confirmara el acceso de las 08:00:42 y buscaríamos el cierre de esa sesión y su actividad en los registros disponibles. Aquí el archivo termina a las 08:05:10 y no contiene comandos ejecutados. Las dos IP pertenecen a rangos reservados para documentación.
En reference.md tienes los hechos del caso para contrastarlos con tu respuesta. Si el modelo da por confirmado un ataque o describe acciones posteriores que no aparecen en el archivo, se ha adelantado a la evidencia.
7. Haz cuentas y apaga la GPU
Al terminar las peticiones, vuelve a Despliegues, entra en la fila del modelo y elige Estado del modelo → Apagar modelo. Espera a que aparezca Detenida. La instancia consume cómputo mientras está encendida, también entre consultas.
En la primera sesión, entre la orden de arranque y la de apagado pasaron unos 33 minutos. Multiplicados por 0,41 €/h, son aproximadamente 0,23 € de cómputo estimado. Es un cálculo de la sesión, no el importe comprobado en una factura; no hemos medido el instante exacto de inicio y fin de la facturación.
La sesión adicional para revisar PHP duró unos 12 minutos entre esas órdenes, aproximadamente 0,08 € a la misma tarifa. Las dos sesiones suman unos 0,31 € estimados.
El coste depende de las horas encendida, incluso si envías pocas consultas.
Los 0,41 €/h corresponden a nuestro despliegue con 8192 tokens de contexto. Otra capacidad puede tener una tarifa distinta. Incluye arranque y pausas al calcular tu presupuesto.
Si vas a usarla a diario, puedes programar el encendido y apagado. Serverless permite arrancarla cuando llegan peticiones; activarlo elimina las reglas de programación existentes. Una petición con el modelo apagado tendrá que esperar al arranque.
El equipo puede llamar al mismo nombre ciberseguridad-qwen desde sus herramientas, con las claves y permisos de la cuenta. La tarifa es por el cómputo del despliegue, no una cuota por cada persona. Cuántas peticiones admite a la vez dependerá de la capacidad y del trabajo que le envíes; no hemos medido concurrencia en esta prueba.